How to Generate New Ideas from Papers
内容简要概括
这份笔记整理的是:如何从一篇已有 paper 中系统地找到 research gap,并进一步生成可执行的 follow-up research idea。核心流程是先拆解 paper 的 research question、research hypothesis、experimental setup 和 limitations,再通过改变任务、评价方式、方法设计或问题表述来形成新 idea,最后用 related work、follow-up work 和专家反馈不断迭代。
最值得记住的是:一个好的 research idea 通常不是凭空出现的,而是从“论文声称了什么”“实验实际验证了什么”“还有什么没有被验证”之间的差距中长出来的。
research question
research hypothesisgapexperimental setupbaselinecomparisonbenchmarkrelated workfollow-up workCLIPCheXzerovision-language modelcontrastive learning
目录
- #整体 workflow
- #Warm-up:先尝试生成 idea
- #第一步:从 paper 中识别 gap
- #第二步:基于 gap 生成 follow-up idea
- #第三步:迭代和筛选 research idea
- #案例:CLIP 和 CheXzero
- #阅读与检索模板
- #来源与待核验内容
整体 workflow
读 paper
-> 找 research question
-> 写出 research hypothesis
-> 找 gap
-> 生成 idea
-> 迭代 idea
-> 检查 idea 是否已经被做过
-> 读 related work / follow-up work
-> 找 experts 反馈
-> 再次迭代 idea
Warm-up:先尝试生成 idea
在正式学习方法前,可以先做一个练习:
如果要基于
CLIP发表一篇 follow-up research paper,你会提出哪 3 个最好的 idea?
原始笔记中的初始想法:
- 原始
pre-training task只是匹配image和caption,能否换成更有挑战性的pre-training task,从而提高模型能力? CLIP的方法最初主要用于 CV 领域,能否应用到医学领域,例如医学影像和诊断报告?CLIP使用图像和文字说明配对,能否改成视频和弹幕配对?
这些想法已经触及了三个常见方向:
- 改变
training task - 改变应用领域
- 改变输入模态或数据配对方式
第一步:从 paper 中识别 gap
1. 找 research question 中的 gap
先把 paper 拆成三个层次:
research question:论文想回答的总体问题是什么?research hypothesis:作者具体预测了什么可测试的结果?gap:总体问题和具体假设之间,还有哪些假设没有被测试?
research hypothesis 指的是:研究者对研究结果的精确、可测试预测。它应该能被实验支持或反驳,而不是泛泛的研究愿景。
Example 1
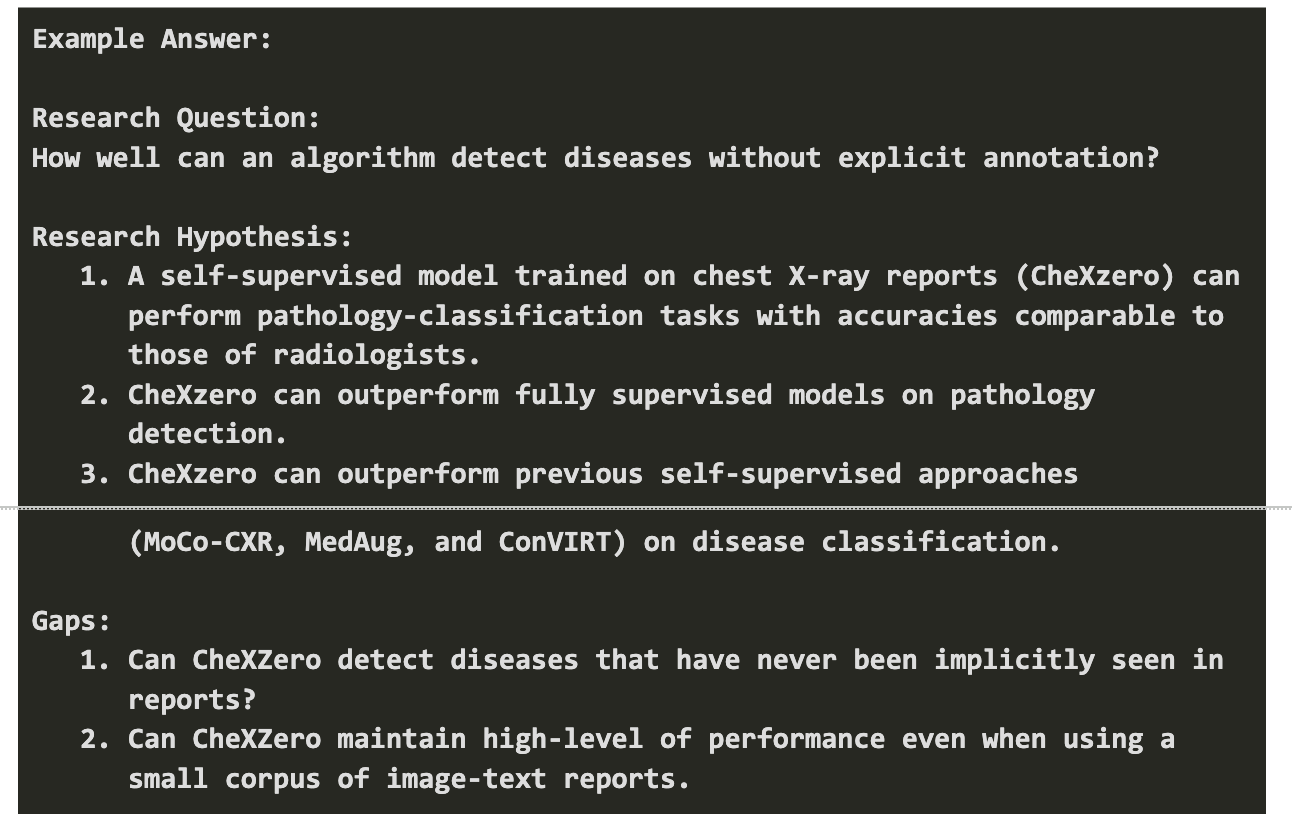
Example 2:CLIP
Research question
大规模 image-text pairs 训练出来的 vision-language model,能在多大程度上学到通用视觉表征?
Research hypotheses
- 在大规模
image-text pairs上训练的 contrastivevision-language model,例如CLIP,可以在不进行 task-specific fine-tuning 的情况下,实现较强的zero-shot image classification。 - 扩大 image-text 数据规模可以得到更可迁移的视觉特征,并在多种 downstream tasks 上超过 supervised ImageNet 模型。
- 学到的 embedding space 可以对齐图像和文本,从而支持大规模
image-to-text和text-to-imageretrieval。
Potential gaps
CLIP在显著的 distribution shift 下是否仍然稳健,例如 medical imaging、satellite imagery 或其他非自然图像领域?CLIP是否支持 compositional 或 multi-step visual reasoning,而不仅仅是分类和 retrieval?CLIP对 image-text pairs 中的噪声和 bias 有多敏感,例如弱 caption、错误 caption 或 adversarial caption?
2. 找 experimental setup 中的 gap
明确 research hypotheses 之后,下一步是检查 experimental setup 是否真的能验证这些假设。
这一部分关注的不是实验结果好不好,而是:
实验设计本身是否真的能验证 paper 提出的
research hypothesis?
核心问题
- 方法是如何被评估的?
- 评价指标是否能真正反映 hypothesis 想证明的能力?
baseline/comparison是否选择合理?- 对比实验是否公平?
- 实验设置是否足够全面?
- 实验是否能 decisive 地验证
research hypothesis?
常见 experimental setup gaps
Evaluation gap:评价方式不充分
实验使用的 metric 或 task 可能不能充分验证 hypothesis。例如 hypothesis 声称模型具有 generalization ability,但实验只在一个固定 dataset 上测试 accuracy,那么 gap 就是:实验没有充分测试模型在不同分布、不同任务上的泛化能力。
Comparison gap:对比方法不合理
paper 可能选择了不够强、不够公平,或设置不一致的 baseline。例如新方法使用了更多数据、更多调参或更大训练预算,而 baseline 没有得到同等条件,那么即使新方法效果更好,也不能完全说明方法本身更优。
Implementation gap:实现方式不公平
有时对比方法的实现细节会影响结论。例如 baseline 没有使用作者公开的最佳实现,或者不同方法的数据增强、训练预算、模型规模不一致。这种情况下,实验可能无法公平验证 hypothesis。
Scope gap:实验范围太窄
paper 提出的 hypothesis 可能比较宽泛,但实验只覆盖了很窄的场景。例如 hypothesis 声称方法适用于 general visual representation learning,但实验只在 natural image classification 上测试,那么实验范围不足以支持 “general” 这个结论。
3. 从 limitations 中找 gap
gap 可以来自两类位置:
- Explicit limitations:作者在
Limitations、Discussion、Future Work中明确写出的限制。 - Implicit limitations:结果表格、失败案例、低分任务、异常结果中暴露出来的隐含问题。
常见线索包括:
Future work could explore...
Our method does not address...
One limitation is...
Our model struggles with...
这些句子可以直接转化成 research gap。例如:
CLIP struggles with compositional reasoning.
可以转化为:
How can we improve compositional reasoning in vision-language models?
第二步:基于 gap 生成 follow-up idea
1. 改变 task of interest
可以问:
- 能否把核心思想应用到不同 modality?
- 能否换成不同 data type?
- 能否把 method 或 learned model 用到不同 task?
- 能否改变 outcome of interest?
例子:
- Pathology slides 经常有对应的 reports,能否把 pathology slides 和 reports 配对,做 disease detection?
- Report 不一定必须是文本,能否把 medical images 和 genomic alterations 配对,做类似的 contrastive learning?
CheXzero能否用于 object detection、semantic segmentation 或 medical image question answering?- 不只看 accuracy,能否研究 robustness、data efficiency,或者不同 patient subgroups 上的表现?
2. 改变 evaluation strategy
可以问:
- 能否换一个 dataset?
- 能否换一个 metric?
- 能否分析方法为什么有效或为什么失效?
- 能否加入不同 comparison?
例子:
CheXzero主要考虑CheXpert、MIMIC-CXR和PadChest,但还可以考虑其他 patient distribution 或 disease detection task,例如Shenzhendataset 的 tuberculosis detection,或RANZCR CLiP的 line positioning task。AUC可以评价 discriminative performance,但无法说明模型是否 calibrated。可以增加 calibration curve、ECE 等 calibration 相关分析。- 可以研究 report 中 disease-specific words 的出现频率是否和不同 pathology 上的性能相关,从而解释某些类别表现好、某些类别表现差的原因。
- 可以收集更多 radiologist annotations,把模型和 radiologists 在新 dataset 上进行比较。
3. 改变 proposed method
这组问题尤其适合 deep learning method paper,但其他研究领域也可以类比使用。
可以问:
- 能否改变 training dataset 或 data elements?
- 能否改变
pre-training/ training strategy? - 能否改变 deep learning architecture?
- 能否改变 problem formulation?
例子:
CheXzero使用MIMIC-CXR,因为它有 images 和 reports。后续可以加入IU X-Ray/OpenI,也可以尝试使用 radiology report 的Findingssection。CheXzero从预训练的 OpenAI model 开始,但后续可以尝试更大的 checkpoints,例如来自LAION-5B的模型。- 可以在 image-text contrastive loss 之外加入 masked-language modeling 等训练目标。
- 不一定使用独立的 unimodal image encoder 和 text encoder,也可以探索 multimodal encoder。
- 当前 formulation 通常把一个输入视为一张 chest X-ray,但一次检查可能包含多张 view。可以把问题扩展成 multi-view input。
第三步:迭代和筛选 research idea
一个 idea 不一定是好 idea。常见问题包括:
- 它没有解决真实问题。
- 它已经被发表过。
- 它不可行,例如数据、算力、标注或评估条件不具备。
- 它的贡献不够清晰。
1. 检查 idea 是否已经被做过
不要只搜索一个标题。应该把 idea 拆成多个关键词维度,再组合搜索。
例如 idea 是:
用 CLIP-like contrastive learning 处理 histopathology images 和 clinical text。
把 CLIP 应用到医学病理图像和基因突变预测上。
不要只搜:
CLIP for histopathology
应该拆成:
方法: contrastive learning / CLIP / vision-language model
数据: histopathology / pathology / whole slide image
辅助模态: text / genomic alteration / mutation / report
任务: classification / retrieval / prediction
再用公式组合:
[method keyword] + [domain keyword] + [modality/task keyword]
例如:
contrastive learning histopathology text
CLIP histopathology report
vision-language pretraining pathology images
multimodal contrastive learning pathology genomic alteration
self-supervised contrastive learning medical imaging genetics
2. 阅读 important related works 和 follow-up works
提出 follow-up research idea 之后,不要马上开始实验,而是先系统阅读相关工作。核心目的不是“读更多 paper”,而是判断 idea 在已有研究中的位置,并不断修正、强化它。
从原 paper 的 Related Work 开始
Related Work 通常会告诉你:
- 这篇 paper 建立在哪些已有工作上;
- 有哪些 alternative approaches;
- 作者认为哪些方法有价值;
- 本文和已有方法的区别是什么。
阅读 Discussion / Limitations / Future Work
这些部分经常直接暗示后续研究方向。把作者明确承认的 limitation 转化为可测试的新 hypothesis,是最自然的 idea 生成方式之一。
阅读 dataset 或 benchmark paper
如果实验依赖某个 dataset 或 benchmark,最好阅读它们的原始 paper。否则很容易误解任务定义、label 构造、数据偏差或评价指标。
用 Google Scholar 的 Cited by 找 follow-up works
如果原 paper 已经发表了一段时间,可以在 Google Scholar 搜索原 paper,然后点击 Cited by。这些后续论文通常包括:
- 改进原方法的 paper;
- 分析原方法弱点的 paper;
- 将原方法应用到新领域的 paper;
- 构造新 benchmark 测试原方法的 paper。
在 arXiv 搜最新论文
不要只搜索原 paper 名字,要使用多个相关术语。例如研究 CLIP compositional reasoning,可以搜索:
CLIP compositional reasoning
vision-language model compositionality
CLIP spatial reasoning
CLIP counting
contrastive vision-language model compositional understanding
同时搜索同义表达:
vision-language pretraining
image-text contrastive learning
multimodal contrastive learning
cross-modal representation learning
按 task 或 benchmark 搜索
如果已经明确 task,例如:
compositional reasoning
robustness
fine-grained recognition
medical image-text retrieval
可以直接搜索:
vision-language compositional reasoning benchmark
CLIP robustness benchmark
fine-grained vision-language recognition
medical vision-language pretraining benchmark
这种方法能帮助你找到当前常用 benchmark、主流评价指标、SOTA 方法和这个 task 的主要难点。
3. 找 experts 反馈
写下具体 idea 后,可以找相关 experts 寻求 feedback。最直接的方式通常是先找自己的导师或熟悉该方向的同学。反馈重点不是让别人替你决定做什么,而是检查:
- 这个问题是否重要?
- 这个 idea 是否已经有人做过?
- 实验是否可行?
- 贡献是否清楚?
- 有没有更合适的 dataset、metric 或 baseline?
案例:CLIP 和 CheXzero
CLIP:从通用 vision-language pretraining 找 gap
CLIP 的核心 idea 是用大规模 image-text pairs 做 contrastive learning,使 image encoder 和 text encoder 学到共享 embedding space。围绕 CLIP 可以从以下方向找 gap:
- Domain shift:在 medical imaging、satellite imagery 等非自然图像领域是否仍然有效?
- Compositional reasoning:是否理解 object、attribute、relation、order,而不是只抓关键词?
- Data quality:对 noisy captions、biased captions、adversarial captions 是否敏感?
- Evaluation:只看 zero-shot classification 是否足够?是否需要 retrieval、calibration、robustness 和 subgroup performance?
CheXzero:从医学 vision-language model 找 gap
CheXzero 可以看作把 CLIP-like contrastive learning 应用到 chest X-ray 和 radiology reports。整理版中的独立索引见 CheXzero。
Research hypotheses with experimental setups
-
Hypothesis: 在 chest X-ray reports 上训练的 self-supervised model,可以在 pathology-classification tasks 上达到接近 radiologists 的表现。
Setup: 在来自单一机构的 500 个 studies test set 上评估,reference standard 由 majority vote 设定;与 3 位 board-certified radiologists 的平均表现比较,使用 5 个 diseases 上的F1和MCC。 -
Hypothesis:
CheXzero可以在 pathology detection 上超过 fully supervised models。
Setup: 在CheXperttest set 的 5 个 pathologies 上用平均AUC评估;比较方法包括 supervisedDenseNet121baseline 和DAM。 -
Hypothesis:
CheXzero可以在 disease classification 上超过之前的 self-supervised approaches,例如MoCo-CXR、MedAug和ConVIRT。
Setup: 使用与上面类似的 test set、metric 和 comparison。
Experimental setup gaps
- 对 hypothesis 1 来说,radiologists 数量可能太少,不足以 decisive 地证明模型“绝对接近 radiologist-level performance”。还需要更清楚地说明 radiologists 的经验和训练背景。
- 对 hypotheses 2/3 来说,评估的 pathologies 数量受 test set 样本数限制。更大范围的 pathologies 会更有力地支持结论。
- 对 hypothesis 3 来说,比较的 self-supervised approaches 数量有限,只包括
MoCo-CXR、MedAug和ConVIRT。还可以加入更多 self-supervised learning algorithms。 - 对 hypothesis 3 来说,不清楚不同 comparison 是 single model 还是 ensemble model,也不清楚它们是否使用相同训练来源。
Explicit limitations
- self-supervised method 仍然需要反复查询 labeled validation set,用于 hyperparameter selection,以及在计算
MCC和F1时确定 condition-specific probability thresholds。 - 当前方法主要限于 image classification,但医学数据常常包含不同 imaging modalities、EHR 等 non-imaging data,或者 time series。比如 MRI 和 CT 会产生 3D data。
- 类似方法可以应用到其他“医学数据 + 非结构化文本”的任务,例如用 pathology reports 描述 histopathology scans 中的 cancer diagnosis。
- 后续工作需要探索如何把方法扩展到更大 image sizes,以便更好地分类较小 pathologies。
Implicit limitations from results
- 模型在 atelectasis 和 pleural effusion 上的
MCC低于 radiologists。 - 模型在
PadChest上有不少 findings 的AUC低于 0.700。 CheXzero在PadChest的No Findingdetection 上表现较弱,AUC为 0.755。
阅读与检索模板
Reading list 模板
| Paper | Year | Why Read It? | Key Idea | Dataset / Task | Limitation | Relation to My Idea |
|---|---|---|---|---|---|---|
| CLIP | 2021 | Base paper | Image-text contrastive learning | Zero-shot classification | Weak compositionality | Starting point |
| Winoground | 2022 | Benchmark | Tests compositional reasoning | Image-text matching | Small dataset | Evaluation for my idea |
| ARO | 2023 | Benchmark | Tests attribution, relation, order | VLM compositionality | Mainly evaluation | Related benchmark |
阅读每篇 paper 时重点记录:
- 它解决什么问题?
- 它的核心方法是什么?
- 它使用什么 dataset 和 experimental setup?
- 它有哪些 limitation?
- 它和我的 idea 有什么关系?
- 它是否支持、削弱或改变了我的 idea?
Workflow 总结
1. Start from the base paper.
2. Extract keywords from Related Work.
3. Read papers cited by the base paper.
4. Use Google Scholar "Cited by" to find follow-up papers.
5. Search arXiv using multiple keyword variants.
6. Search by task or benchmark.
7. Read dataset / benchmark papers if your experiments rely on them.
8. Maintain a structured reading list.
9. Update your research idea after each important paper.
来源与待核验内容
- 原始教程链接:Google Doc
- 本次整理尝试把原始 Google Doc 作为补充来源,但当前环境无法稳定读取其正文内容。因此,整理版主要基于当前目录中的原始笔记,不额外编造原教程末尾未提供的扩展示例。
- 如果之后能导出原始 Google Doc,可继续补充“Some example”部分中的更多 paper examples。